Depuis l'arrivée des assistants conversationnels, les journaux de votre serveur voient défiler de nouveaux visiteurs : les crawlers IA. GPTBot, ClaudeBot, PerplexityBot ou OAI-SearchBot explorent les pages du web pour entraîner des modèles de langage ou pour alimenter des réponses en temps réel. Le fichier robots.txt, conçu il y a plus de trente ans pour les moteurs de recherche, redevient ainsi un outil stratégique : il permet d'autoriser certains robots, d'en bloquer d'autres et de décider si vos contenus doivent nourrir les IA, apparaître dans leurs réponses, ou les deux. Ce guide technique détaille les principaux agents, la syntaxe des règles, les arbitrages possibles et les moyens de vérifier qu'elles sont respectées.
Qui sont les crawlers IA qui explorent votre site ?
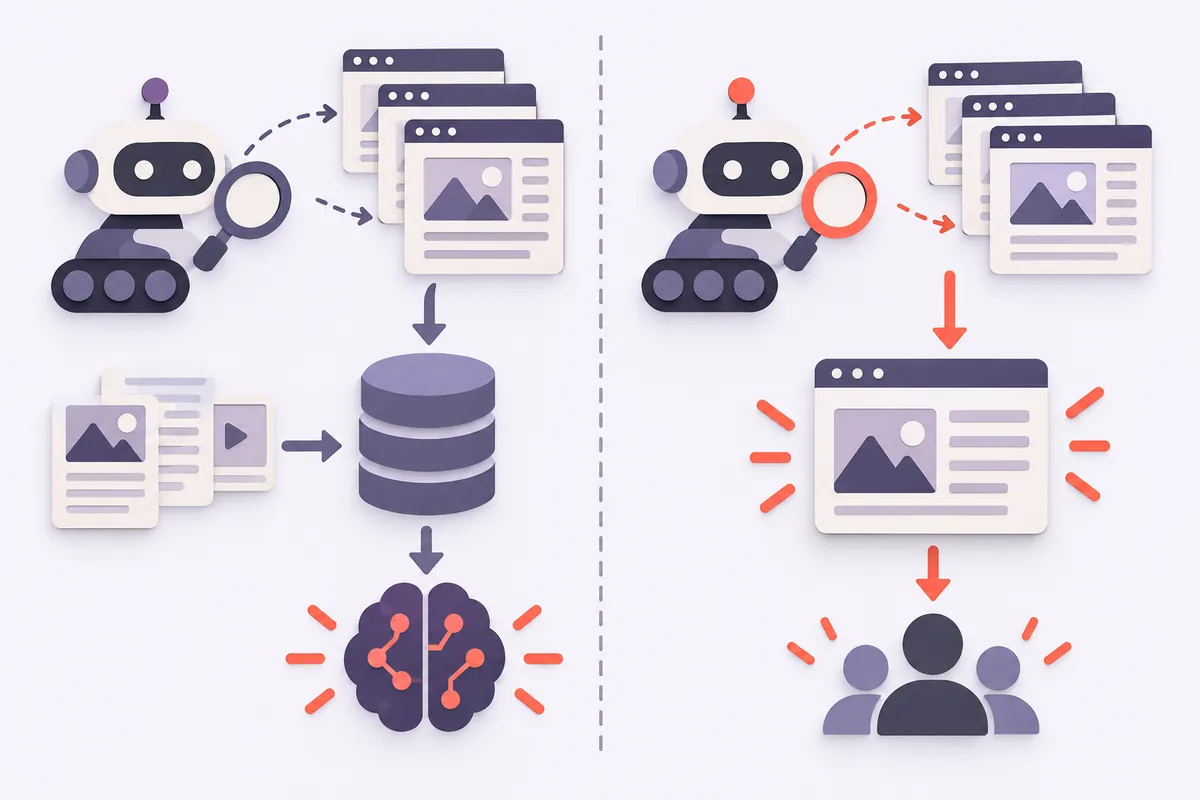
Tous les robots d'intelligence artificielle n'ont pas le même rôle. Les éditeurs distinguent aujourd'hui trois familles d'agents, chacune identifiée par un user-agent propre : les robots d'entraînement, qui collectent des pages pour constituer les corpus des futurs modèles ; les robots de recherche, qui indexent le web pour citer des sources dans les réponses ; et les agents déclenchés par un utilisateur, qui consultent une page précise au moment où quelqu'un pose une question. Cette distinction est essentielle, car bloquer l'une de ces familles n'a pas du tout les mêmes conséquences que bloquer les autres. Avant toute règle, il faut donc savoir qui passe réellement sur votre site, ce que révèle l'analyse des journaux serveur, bien plus fiable que les suppositions.
Les robots d'entraînement des modèles
GPTBot (OpenAI), ClaudeBot (Anthropic), CCBot (Common Crawl, dont les archives servent à de nombreux modèles) ou Meta-ExternalAgent collectent massivement des pages pour entraîner les modèles de langage. Leur passage ne produit aucun trafic direct : vos textes deviennent une partie de la connaissance générale du modèle, sans lien ni citation. Bloquer ces robots empêche que vos futurs contenus soient utilisés pour l'entraînement, sans effet rétroactif sur les données déjà collectées. Google fonctionne différemment : il n'existe pas de robot distinct, mais un jeton de contrôle, Google-Extended, que l'on cible dans le robots.txt pour refuser l'usage de ses pages par les modèles Gemini, sans toucher au classement dans la recherche Google. Apple propose un mécanisme comparable avec Applebot-Extended.
Les robots de recherche et de réponse
Une deuxième famille explore le web pour alimenter les moteurs de réponse. OAI-SearchBot indexe les pages qui peuvent apparaître comme sources dans la recherche de ChatGPT, PerplexityBot constitue l'index de Perplexity, et Anthropic a documenté un Claude-SearchBot pour son propre usage. Ces robots se comportent comme des moteurs de recherche classiques : s'ils ne peuvent pas lire vos pages, celles-ci ne seront pas proposées comme sources citées, avec le lien cliquable qui les accompagne. Pour une entreprise qui cherche à gagner en visibilité, c'est le point le plus sensible. Les bloquer revient à renoncer à une partie de la stratégie de GEO que vous pourriez construire, alors même que ces réponses captent une part croissante des recherches informationnelles.
Les agents déclenchés par un utilisateur
Enfin, des agents comme ChatGPT-User, Claude-User ou Perplexity-User visitent une page à la demande, lorsqu'un utilisateur colle une adresse dans la conversation ou que l'assistant décide de consulter une source en direct. Ces visites ressemblent davantage à celles d'un navigateur qu'à une exploration systématique. Certains éditeurs indiquent d'ailleurs que ces agents, agissant pour le compte d'une personne, n'appliquent pas toujours les règles du robots.txt de la même manière que leurs robots d'exploration. Leur volume reste faible, mais ils sont un bon indicateur : si vos journaux en contiennent, c'est que vos pages circulent déjà dans les conversations. Il est utile de les isoler dans vos analyses pour suivre cette forme discrète de visibilité conversationnelle.
Écrire les règles robots.txt pour les crawlers IA
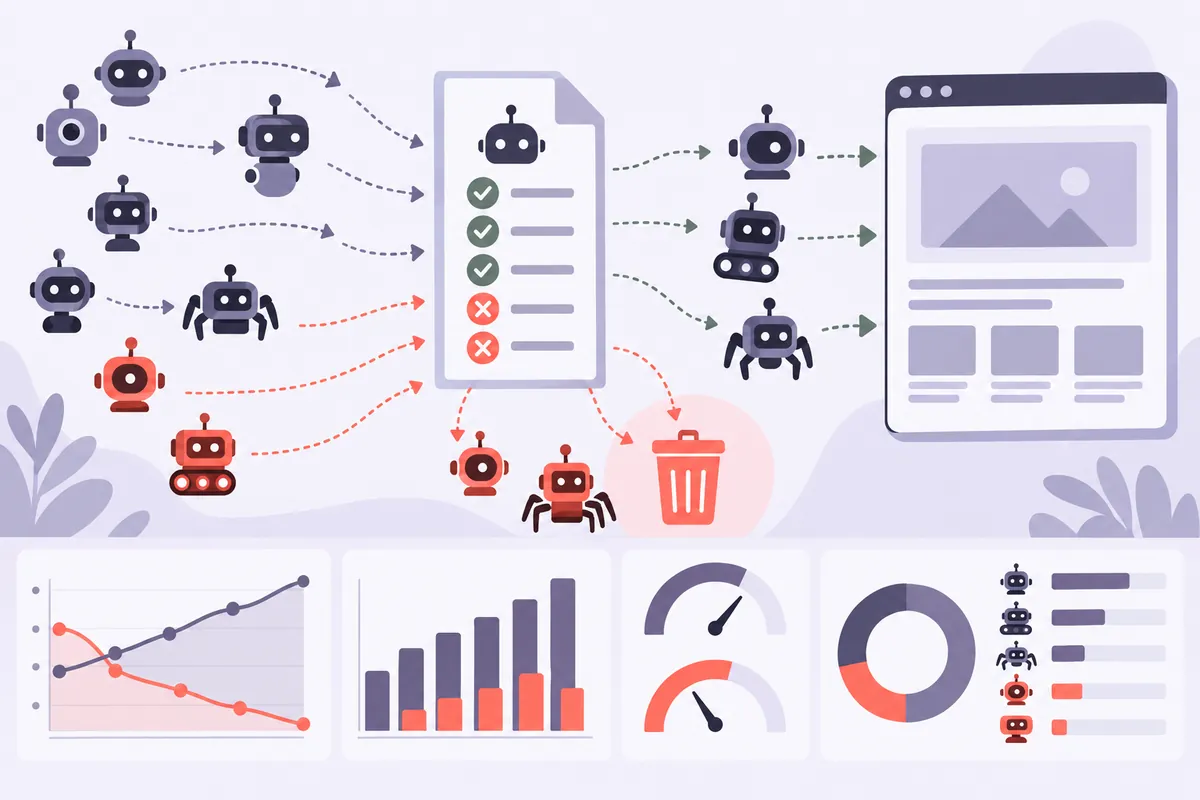
Le fichier robots.txt se place à la racine du domaine et se lit par groupes : chaque groupe commence par une ou plusieurs lignes User-agent, suivies de directives Disallow et Allow. Un robot applique le groupe qui le désigne le plus précisément et ignore les autres ; s'il n'en trouve aucun, il suit le groupe générique User-agent: *. Les noms d'agents ne tiennent pas compte de la casse, contrairement aux chemins. Le tableau ci-dessous récapitule les principaux agents et l'effet d'un blocage, selon la documentation publiée par les éditeurs à la date de rédaction ; ces listes évoluent vite, il faut les vérifier régulièrement.
| Agent | Éditeur | Rôle principal | Effet d'un blocage |
|---|---|---|---|
| GPTBot | OpenAI | Entraînement des modèles | Contenus exclus des futurs entraînements |
| OAI-SearchBot | OpenAI | Index de la recherche ChatGPT | Pages absentes des sources citées |
| ChatGPT-User | OpenAI | Visite à la demande | Page non consultée en direct |
| ClaudeBot | Anthropic | Entraînement des modèles | Contenus exclus des futurs entraînements |
| PerplexityBot | Perplexity | Index de Perplexity | Pages absentes des réponses sourcées |
| Google-Extended | Jeton d'usage pour Gemini | Aucun effet sur la recherche Google | |
| CCBot | Common Crawl | Archive ouverte du web | Exclusion des futures archives |
Autoriser la recherche, refuser l'entraînement
Le scénario le plus courant pour une entreprise consiste à rester visible dans les réponses tout en refusant l'entraînement. Il suffit de créer un groupe pour chaque robot d'entraînement avec Disallow: /, et de laisser les robots de recherche accéder au site, soit par un groupe dédié avec Allow: /, soit simplement en ne les mentionnant pas. Concrètement, on bloque GPTBot, ClaudeBot, CCBot et Google-Extended, tandis qu'OAI-SearchBot et PerplexityBot restent autorisés. Ce réglage n'a aucun effet sur Googlebot ni sur Bingbot, qui continuent d'explorer normalement. Attention en revanche aux blocages trop larges : une règle Disallow: / sous User-agent: * bloquerait aussi les moteurs classiques et provoquerait une chute brutale de votre référencement, un cas que l'on rencontre encore lors d'une mise en ligne précipitée.
Protéger certaines sections seulement
Le blocage peut aussi être partiel. Un site peut ouvrir ses guides et ses pages de services aux crawlers IA tout en fermant un espace client, des fiches aux prix négociés ou des contenus premium. On combine alors des directives Disallow ciblées sur des répertoires et des Allow plus précis pour les exceptions, la règle au chemin le plus long l'emportant en cas de conflit chez la plupart des robots. Ce découpage suppose une architecture claire, avec des répertoires cohérents, ce qui plaide pour des adresses pensées dès la conception. Rappelons enfin que le robots.txt règle l'exploration et non l'indexation : une page bloquée peut rester connue par ses liens, et une page déjà explorée ne disparaît pas des données existantes du simple fait d'une nouvelle règle.
Les limites du robots.txt
Le robots.txt reste une convention volontaire. Les éditeurs sérieux s'engagent publiquement à la respecter, mais rien n'empêche techniquement un robot peu scrupuleux de l'ignorer, voire d'usurper le nom d'un agent connu. Pour les sites qui veulent une protection réelle, il faut compléter les règles par un filtrage au niveau du serveur ou du pare-feu applicatif, en s'appuyant sur les plages d'adresses IP que publient la plupart des éditeurs. Certains hébergeurs et réseaux de diffusion proposent désormais des options prêtes à l'emploi pour bloquer les robots d'IA. Cette approche demande toutefois de la rigueur, car un filtrage mal réglé peut bloquer par erreur des robots utiles, avec des problèmes d'indexation difficiles à diagnostiquer ensuite.
Crawlers IA : choisir la bonne stratégie pour votre site
Il n'existe pas de réglage universel. Le bon arbitrage dépend de votre modèle économique, de la valeur de vos contenus et de votre besoin de visibilité. Un média qui vit de ses articles n'a pas les mêmes intérêts qu'une PME qui cherche des clients, ni qu'un site e-commerce dont les fiches produits sont copiées partout. La question centrale est simple : vos contenus vous rapportent-ils davantage lorsqu'ils sont lus sur votre site, ou lorsqu'ils font connaître votre entreprise, y compris à travers les réponses d'une IA ? Pour la plupart des entreprises de services, la visibilité dans les réponses l'emporte largement sur le risque de réutilisation.
Le cas d'une entreprise de services
Pour un cabinet, une agence ou un artisan de la métropole lilloise, l'objectif est d'être cité lorsqu'un prospect demande conseil à un assistant. Ouvrir le site aux robots de recherche IA est alors indispensable : un prestataire absent des sources citées laisse le terrain à ses concurrents. L'entraînement pose moins de problèmes, puisque vos pages de présentation et vos guides n'ont pas vocation à être monnayés. Beaucoup d'entreprises choisissent donc d'autoriser l'ensemble des robots, ou de ne bloquer que ceux qui n'apportent aucune visibilité. Cette ouverture n'a de sens que si les pages sont réellement lisibles : un contenu clair, bien structuré et accessible sans script complexe sera mieux compris, comme nous l'expliquons dans notre guide pour être cité par ChatGPT et Perplexity.
Le cas des éditeurs et des contenus premium
Pour un média, un organisme de formation ou un site dont la valeur réside dans des contenus exclusifs, l'équation change. Laisser un modèle absorber des analyses payantes peut affaiblir le modèle économique, puisque l'utilisateur obtient la réponse sans visiter le site. Ces éditeurs bloquent souvent les robots d'entraînement et arbitrent au cas par cas pour les robots de recherche, en fonction du trafic réel qu'ils génèrent. Certains négocient même des accords de licence avec les éditeurs d'IA. Dans tous les cas, la décision doit s'appuyer sur des données : volume de visites des agents, trafic référent venu des assistants, part de contenus réellement stratégiques. Une règle posée par principe, sans mesure, risque de coûter plus qu'elle ne protège.
Mettre à jour les règles dans le temps
Le paysage des crawlers IA évolue tous les trimestres : nouveaux agents, changements de nom, séparation entre robots d'entraînement et de recherche. Un robots.txt rédigé une fois pour toutes devient vite obsolète. La bonne pratique consiste à réviser les règles à intervalle régulier, en comparant la liste des agents présents dans les journaux avec la documentation des éditeurs. Documentez chaque décision dans un fichier interne, avec sa date et sa justification, pour éviter qu'une modification ultérieure ne soit faite à l'aveugle. Cette révision peut s'intégrer à un contrôle technique plus large, avec l'audit technique de votre site qui vérifie aussi les redirections, la vitesse et l'indexation.
Exemples de fichiers robots.txt pour les crawlers IA
Rien ne vaut des exemples concrets pour visualiser les règles robots.txt adaptées aux crawlers IA. Les deux configurations ci-dessous couvrent les situations les plus fréquentes ; elles se combinent avec les règles déjà présentes pour les moteurs classiques, sans les remplacer. Adaptez toujours les noms d'agents à la documentation à jour des éditeurs avant de publier le fichier.
Un site vitrine ouvert à la recherche IA
Pour une entreprise qui veut être citée sans nourrir l'entraînement, le fichier contient un groupe par robot d'entraînement : User-agent: GPTBot suivi de Disallow: /, puis le même schéma pour ClaudeBot, CCBot et Google-Extended. Les robots de recherche IA comme OAI-SearchBot et PerplexityBot ne sont pas mentionnés, ou reçoivent un groupe explicite avec Allow: / pour lever toute ambiguïté. Le groupe générique User-agent: * conserve ses règles habituelles, par exemple le blocage d'un espace d'administration, et la ligne Sitemap indique l'adresse du plan du site. Ce fichier tient en une quinzaine de lignes et reste lisible par n'importe quel membre de l'équipe, ce qui facilite sa maintenance.
Un site qui refuse tout usage par les IA
À l'inverse, un éditeur qui veut tenir ses contenus à l'écart des IA crée un groupe Disallow: / pour chaque agent connu, robots d'entraînement comme robots de recherche. Ce choix a un coût : les pages disparaissent des sources citées dans les réponses, et la marque perd une forme de visibilité en croissance. Il reste en outre incomplet, puisque les agents inconnus ou malveillants ne sont pas concernés. Les sites qui optent pour cette stratégie la complètent presque toujours par un filtrage au niveau du serveur, et réexaminent leur décision périodiquement à la lumière du trafic réellement perdu ou préservé. Dans les deux cas, gardez une copie datée de chaque version du fichier pour pouvoir revenir en arrière rapidement.
Tester le fichier avant de le publier
Avant toute mise en ligne, vérifiez la syntaxe du fichier avec un outil de test robots.txt, comme le rapport dédié de la Search Console, qui signale les lignes mal interprétées. Testez ensuite quelques adresses représentatives pour chaque agent : page d'accueil, article de blog, page de service, espace bloqué. Cette étape évite les erreurs classiques, une barre oblique oubliée, un groupe mal fermé ou une règle générique qui bloque involontairement tout le site. Une fois le fichier publié, contrôlez son accessibilité à l'adresse racine du domaine et vérifiez qu'il renvoie bien un code 200, car un fichier inaccessible peut être interprété de manière imprévisible par certains robots.
Vérifier que les règles pour les crawlers IA sont respectées
Écrire des règles ne suffit pas : il faut contrôler leur effet réel. La première vérification porte sur le fichier lui-même, accessible à l'adresse /robots.txt, servi avec un code 200 et encodé en UTF-8. Un fichier inaccessible ou renvoyant une erreur serveur peut être interprété de manière très différente selon les robots, certains cessant toute exploration par prudence. Ensuite, ce sont les journaux serveur qui disent la vérité : ils montrent quels agents passent, à quelle fréquence, sur quelles pages, et s'ils continuent de visiter des sections théoriquement bloquées.
Analyser les journaux serveur
L'analyse des logs serveur consiste à filtrer les requêtes par user-agent pour isoler GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot et leurs homologues. On observe alors le volume de requêtes, les répertoires visités et les codes de réponse renvoyés. Un robot qui continue d'accéder à une section interdite plusieurs jours après la mise à jour du fichier mérite une enquête. Les outils d'analyse de logs utilisés pour le référencement classique conviennent parfaitement, et un simple export filtré suffit pour un petit site. Cette lecture régulière révèle aussi des informations utiles pour votre stratégie : les pages les plus consultées par les agents de recherche sont souvent celles qui ont le plus de chances d'être citées.
Démasquer les faux robots
Un user-agent se falsifie en une ligne de code. Des scrapers se font donc régulièrement passer pour GPTBot ou Googlebot afin de contourner les blocages ou de gagner en crédibilité. Pour authentifier un robot, on compare son adresse IP aux plages publiées par l'éditeur, que la plupart des acteurs mettent à disposition dans des fichiers JSON régulièrement actualisés, ou l'on effectue une vérification DNS inverse lorsque l'éditeur la documente. Une requête qui se réclame d'OpenAI mais provient d'une adresse hors de ces plages n'est pas légitime et peut être bloquée sans hésiter au niveau du serveur. Cette vigilance protège aussi vos statistiques : les faux robots faussent la lecture des journaux et gonflent artificiellement le volume attribué aux IA.
Suivre l'impact sur la visibilité
La dernière vérification est stratégique : vos règles produisent-elles l'effet attendu ? Si vous avez ouvert le site aux robots de recherche, le trafic référent venu des assistants doit progresser dans vos statistiques, et vos pages doivent apparaître plus souvent comme sources. Si vous avez bloqué l'entraînement, vérifiez qu'aucune baisse inattendue ne touche votre trafic classique, signe d'une règle trop large. Cette boucle de contrôle s'inscrit dans un suivi global de la présence de votre marque dans les moteurs génératifs, qui mêle analyse des journaux, tests de questions et lecture des données structurées Schema.org qui aident les IA à comprendre qui vous êtes.